TECH NOTE
4758 字 24 分钟 系列 3 / 2203 性能对比:五种模式在三种场景下各花多少次调用、多少 Token
ON THIS PAGE / 目录21 节
一句话讲透:多 Agent 模式没有”最好”,只有”这个场景最划算”。官方用三个场景把账算给你看:一次性请求(3 次调用的是 Handoffs/Skills/Router)、同会话重复请求(有状态模式能省 40–50%)、多领域并行(并行模式省 token、串行模式翻车)。
⚠️ 先声明:下面是官方文档为教学对比给出的示意数字(同一套任务、同一套假设),不是严格 benchmark。请重点看相对大小与趋势,不要把绝对值套到你的系统上。
先搞懂两个指标
原文的开场定义:
| 指标 | 原文定义 | 说人话 | 代价 |
|---|---|---|---|
| 模型调用次数(Model calls) | LLM 被调用的次数 | 每调一次模型,用户就多等一段 | 调用越多 → 延迟越高(串行时尤其明显)+ 单请求 API 成本越高 |
| 处理的 Token 总量(Tokens processed) | 所有调用累计消耗的上下文窗口用量 | 每调一次,提示词+历史都要重新”读一遍” | token 越多 → 处理成本越高,还可能撞上下文上限 |
🧭 补充解读(非原文):这两个指标为什么分开看?因为它们的代价形状不一样——
- 调用次数 ≈ 延迟(用户体感)+ 固定开销。串行 7 次调用,用户就得等 7 段。
- token 总量 ≈ 钱(按 token 计费)+ 上下文压力。一个 6K token 的技能反复加载 5 次,就是白烧 30K。
延迟感受 ≈ 调用次数 × 单次耗时(串行时累加;并行时取最长的那条)账单 ≈ token 总量 × 单价(同一份内容被重复读的遍数越多,越贵)场景一:一次性请求(“买咖啡”)
用户:“Buy coffee”(帮我买杯咖啡)
假设:有一个专门的咖啡 Agent / 技能,能调用
buy_coffee工具。
| 模式 | 模型调用次数 | 最合适? |
|---|---|---|
| Subagents | 4 | |
| Handoffs | 3 | ✅ |
| Skills | 3 | ✅ |
| Router | 3 | ✅ |
Subagents:4 次调用
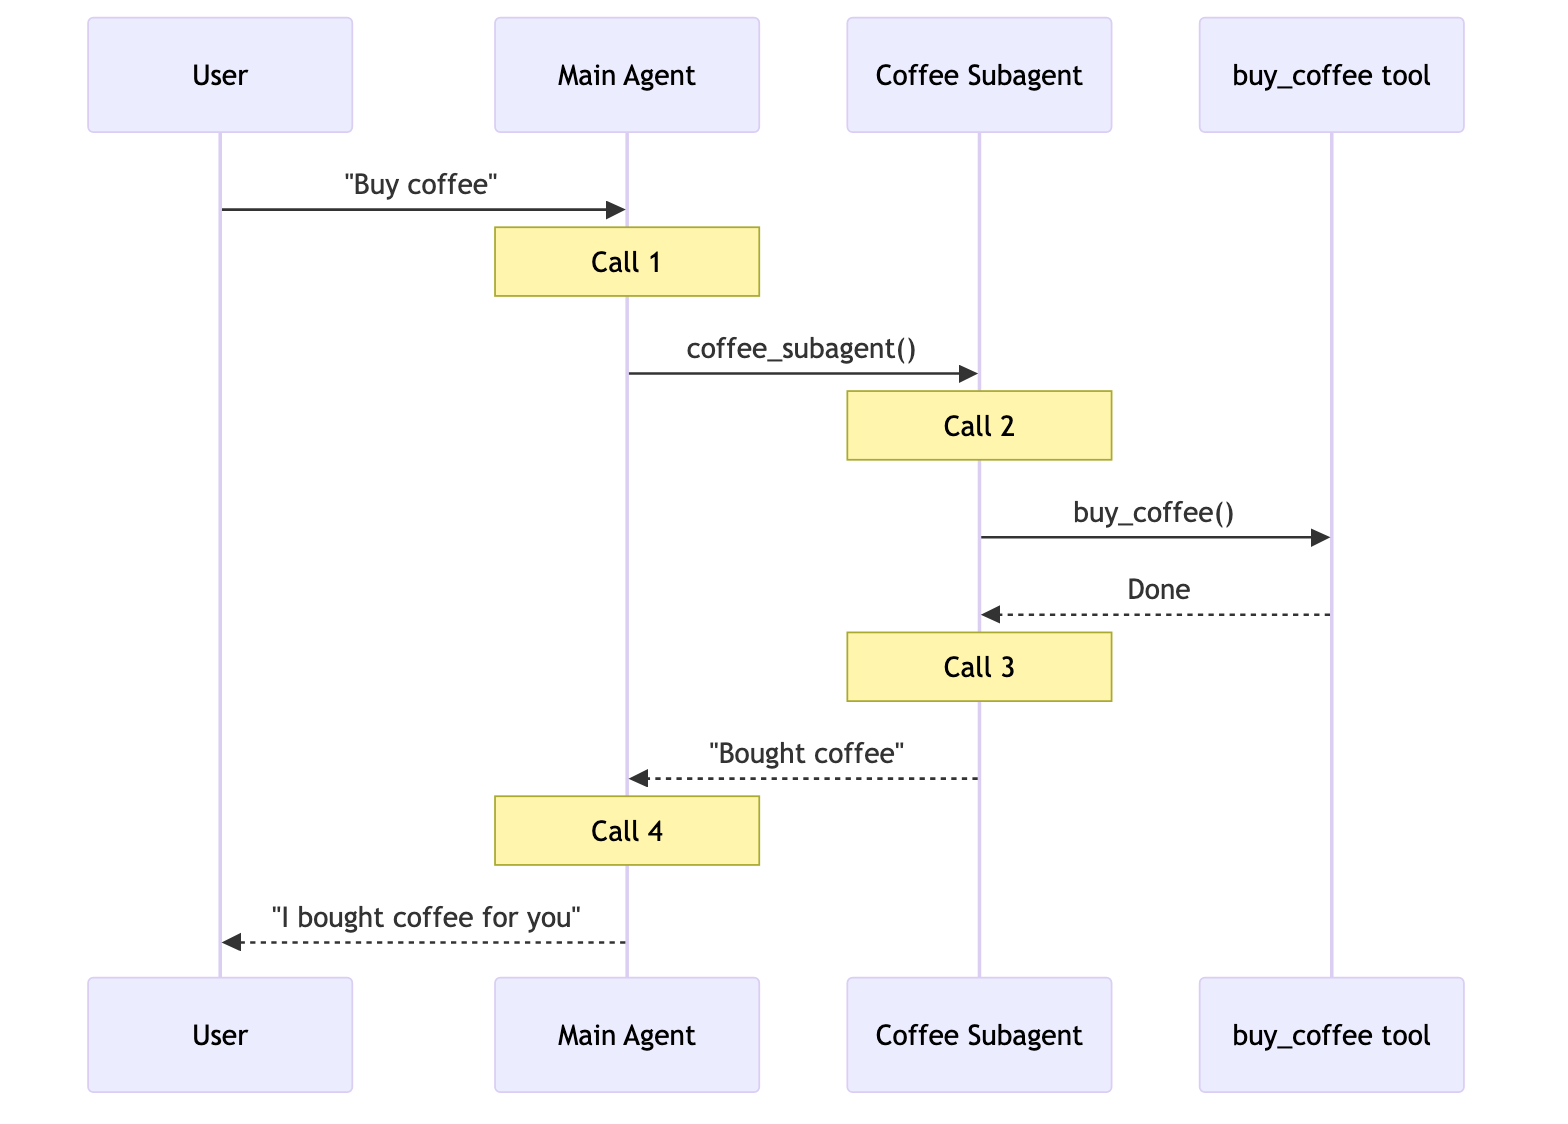
这张图在说什么:官方图注为「Subagents 一次性请求:买咖啡请求共 4 次模型调用」。多出来的那一次,是因为结果要绕回主管。
🧭 补充解读(非原文,按原文结论推演):这 4 次大致是——① 主管决定派给咖啡子智能体;② 咖啡子智能体决定调
buy_coffee;③ 工具结果回来后子智能体作答;④ 主管把结果汇总成人话回给用户。第 ④ 次就是”集中管控”的过路费。✅ 已用真实抓包验证:我们用 DeepSeek 模型 + mitmproxy 跑了一次真实请求,4 次调用各自看到的上下文、原始请求/响应报文、以及”第 4 次究竟买到了什么”,全部记录在 13 附录:Subagents 为什么是 4 次调用——抓包实录(复现脚本见
demo/)。
Handoffs:3 次调用
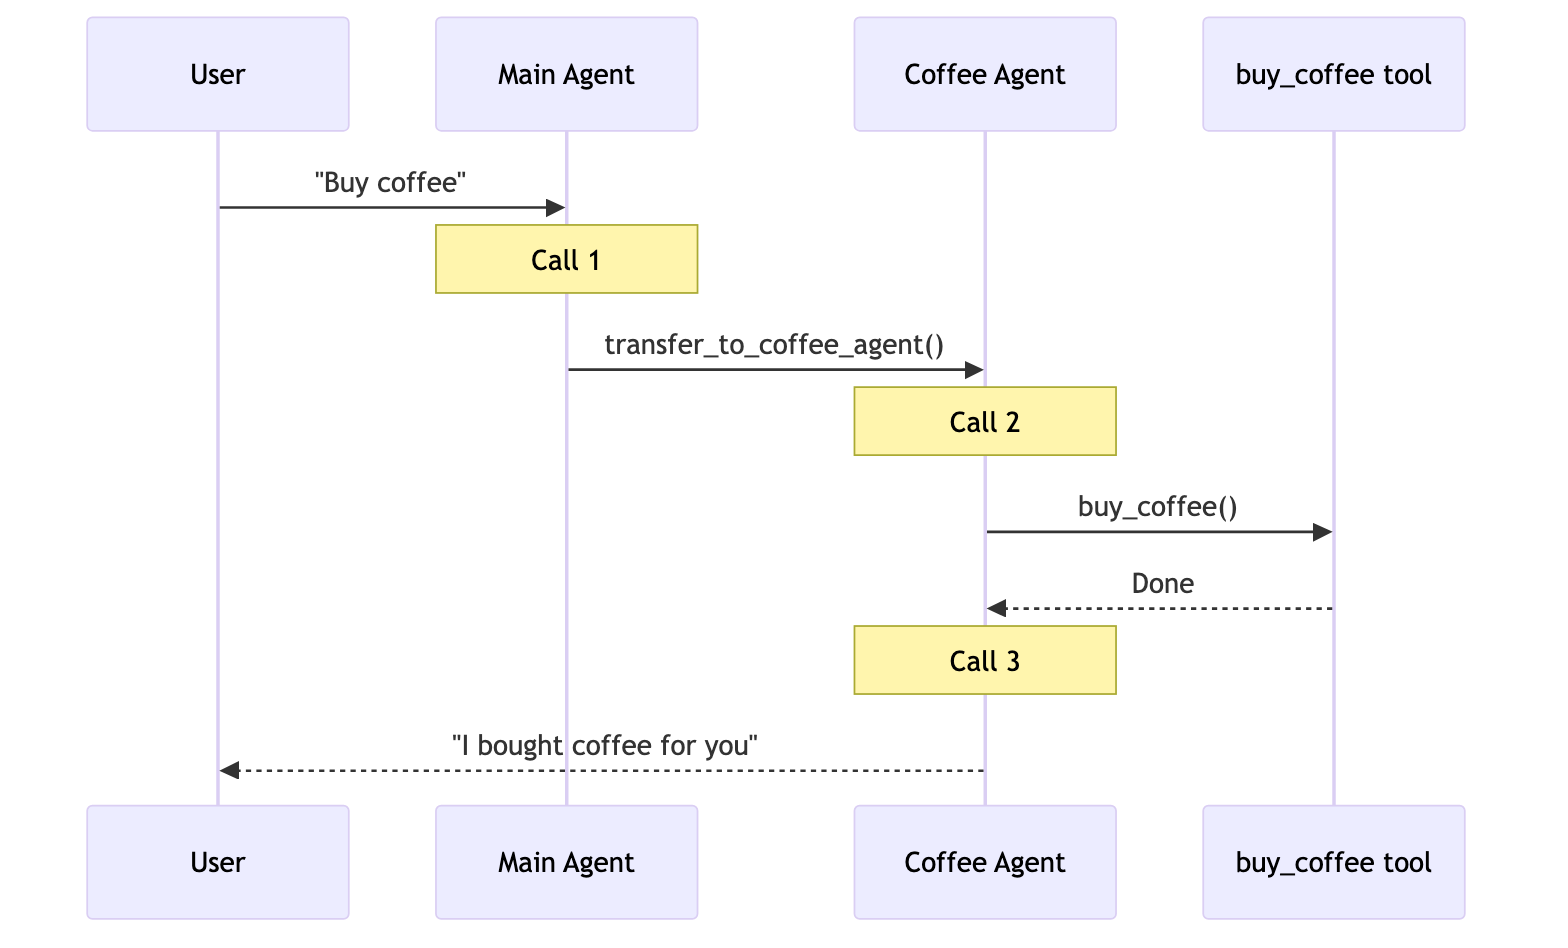
这张图在说什么:官方图注为「Handoffs 一次性请求:买咖啡请求共 3 次模型调用」。没有”回收汇总”这一步,交接完之后由咖啡 Agent 直接对用户说话。
Skills:3 次调用
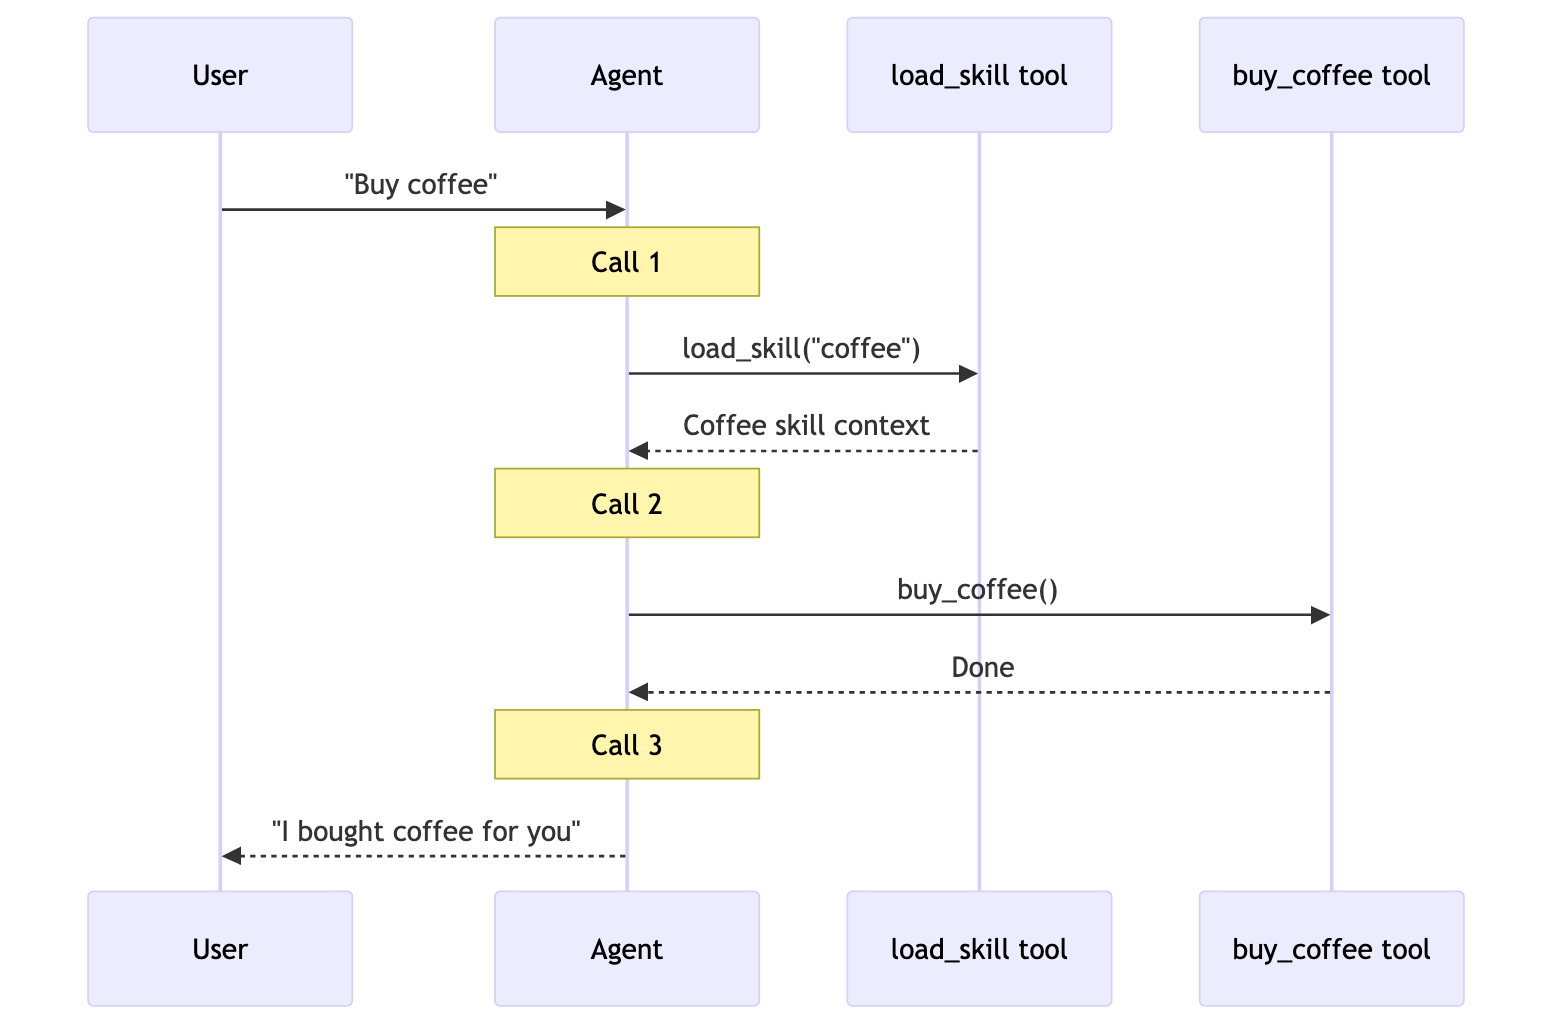
这张图在说什么:官方图注为「Skills 一次性请求:买咖啡请求共 3 次模型调用」。加载技能 → 调工具 → 回答,全程同一个 Agent。
Router:3 次调用
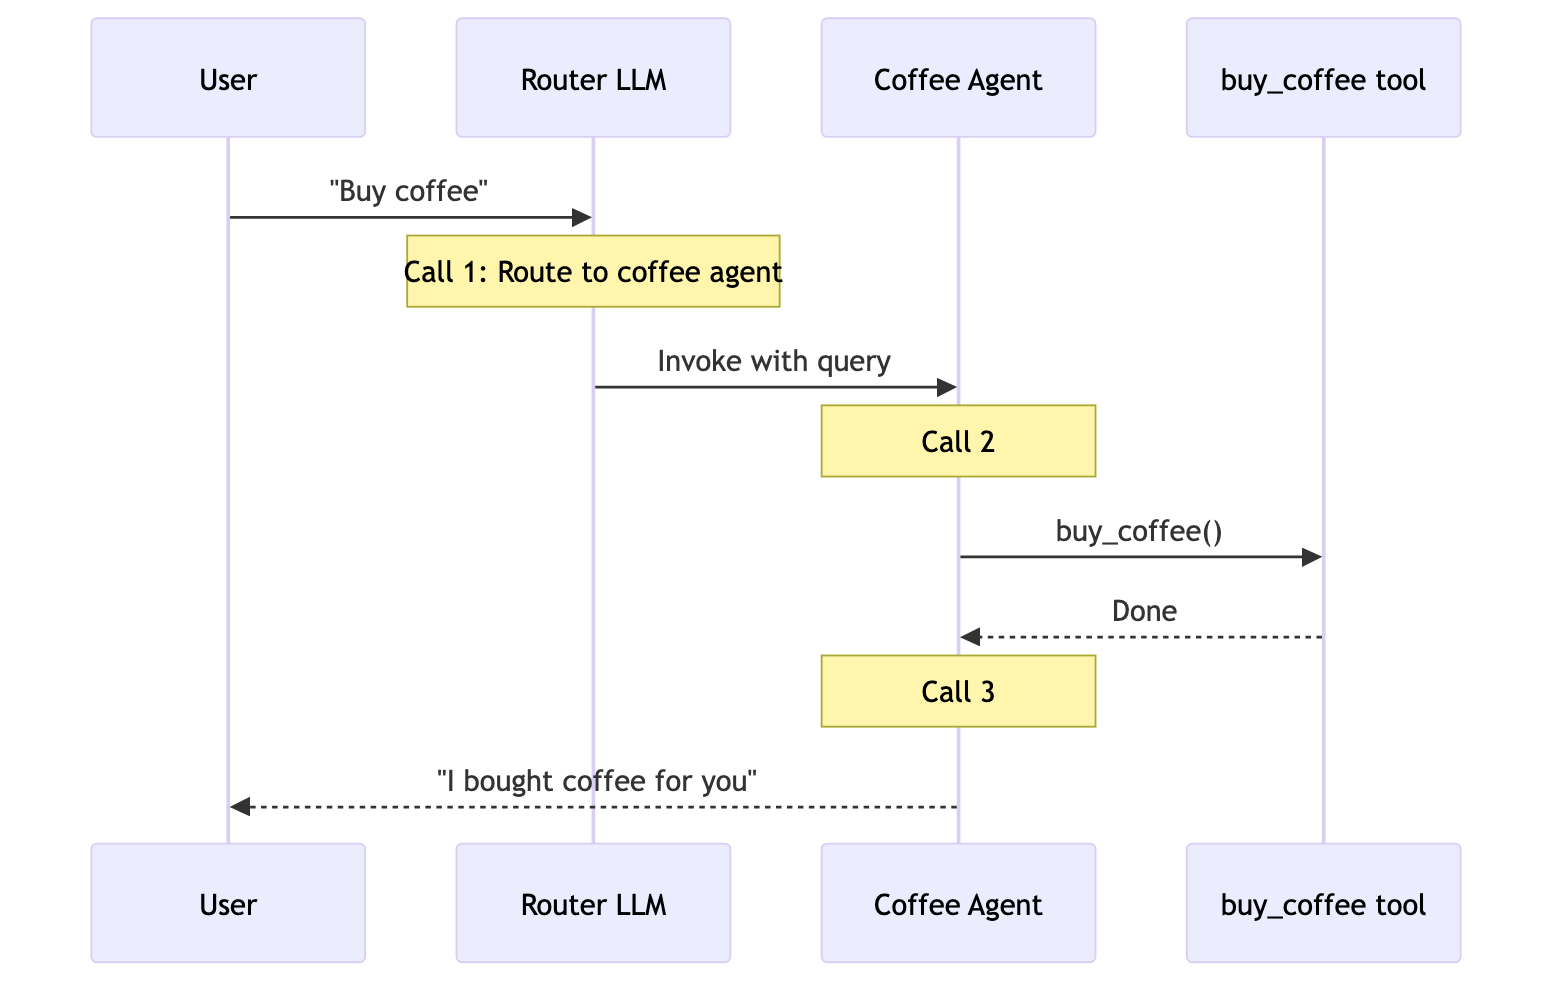
这张图在说什么:官方图注为「Router 一次性请求:买咖啡请求共 3 次模型调用」。原文在重复请求场景里给了精确拆分:路由模型调用(1)→ 专家 Agent 调 buy_coffee(2)→ 专家 Agent 回答(3)。
关键结论(原文)
Key insight:Handoffs、Skills、Router 在单任务上最高效(各 3 次调用)。Subagents 多一次,因为结果要流回主管——这次额外开销换来的是集中控制。
场景二:同一会话里重复请求
第 1 轮:“Buy coffee” 第 2 轮:“Buy coffee again”(再买一次)
关键前提:同一个会话里,用户把同一件事又说了一遍。
| 模式 | 第 2 轮调用次数 | 两轮合计 | 最合适? |
|---|---|---|---|
| Subagents | 4 | 8 | |
| Handoffs | 2 | 5 | ✅ |
| Skills | 2 | 5 | ✅ |
| Router | 3 | 6 |
逐模式看第 2 轮发生了什么(原文结论 + 两轮时序图)
Subagents:还是 4 次 → 合计 8 次
sequenceDiagram participant U as 用户 participant S as 主管 Agent participant C as 咖啡子智能体 participant T as 工具 buy_coffee
Note over U,T: 第 1 轮:买咖啡 —— 4 次模型调用 U->>S: 买咖啡 S->>S: ① 决定派给咖啡子智能体 S->>C: 调用子智能体工具 schedule_event(只给这一句任务描述) C->>C: ② 决定调用 buy_coffee C->>T: buy_coffee() T-->>C: 已下单 C->>C: ③ 读工具结果并作答 C-->>S: 结论文本 S->>S: ④ 汇总成人话 S-->>U: 咖啡买好了
Note over U,T: 第 2 轮:再买一杯 —— 又是 4 次,一模一样 U->>S: 再买一杯 S->>S: ① 重新决定派谁 S->>C: 调用子智能体工具 schedule_event(只给这一句任务描述) Note over C: 无状态:上一轮做过什么,它完全不记得 C->>C: ② 重新决定调用 buy_coffee C->>T: buy_coffee() T-->>C: 已下单 C->>C: ③ 读工具结果并作答 C-->>S: 结论文本 S->>S: ④ 汇总成人话 S-->>U: 咖啡买好了这张时序图在说什么:① 主管每轮固定两次模型调用(派活 ① + 收尾 ④),躲不掉;② 子智能体那一侧的 ②③ 在第 2 轮被原样重放——它每次都在全新上下文里跑,上一轮的事一点不记得;③ 所以 4 + 4 = 8 次,第 2 轮一次没省,换来的是彻底的上下文隔离。
Handoffs:2 次 → 合计 5 次
sequenceDiagram participant U as 用户 participant F as 前台 Agent(第 1 轮的负责人) participant C as 咖啡 Agent participant ST as 工作流状态 participant T as 工具 buy_coffee
Note over U,T: 第 1 轮:买咖啡 —— 3 次模型调用 U->>F: 买咖啡 F->>F: ① 决定交接 F->>ST: transfer_to_coffee() 把 current_step 写成 coffee F->>C: 交接控制权(连带当前对话历史) Note over F,C: 从这一刻起,对用户负责的是咖啡 Agent C->>C: ② 直接调用 buy_coffee C->>T: buy_coffee() T-->>C: 已下单 C->>C: ③ 回复用户 C-->>U: 咖啡买好了
Note over U,T: 第 2 轮:再买一杯 —— 2 次(省掉交接) U->>C: 再买一杯 Note over ST: 状态还在:current_step 仍然是 coffee Note over F,C: 入口先读状态 current_step=coffee<br/>→ 直接按咖啡步骤处理,前台配置不加载 Note over F,C: 所以消息看起来"跳过"了前台<br/>其实是状态把它路由到了咖啡 Agent C->>C: ① 直接调用 buy_coffee C->>T: buy_coffee() T-->>C: 已下单 C->>C: ② 回复用户 C-->>U: 咖啡买好了这张时序图在说什么:① 第 1 轮多出的那一次是**“决定交接”——由当前负责的 Agent(前台)发起,把控制权交给咖啡 Agent,并把 current_step 写成 coffee 存进状态;② 第 2 轮用户的消息直接落到咖啡 Agent**(它就是当前负责人),状态还在,于是跳过交接直接干活;③ 3 + 2 = 5 次,省下的正是”交接”这一步。
📌 注意:图里画的是 Handoffs 的语义(控制权从”当前负责人”转移到”下一步骤的 Agent”)。
05篇讲过这套语义有两种实现——单 Agent + 中间件(其实是同一个 Agent 换上了咖啡步骤的提示词与工具集)或多 Agent 子图(真正的两个图节点 +Command.PARENT跳转)。两种实现下”少一次交接调用”的账是一样的。
🧭 那第 2 轮”前台”为什么不见了?(这是 Handoffs 最容易误读的一点) 因为前台不是一道每次都要经过的关卡,而是一个”状态”。用户的每条消息都进入同一个图 / 同一个 Agent,只是入口会先读状态,再决定这一轮用哪套配置来处理:
- 单 Agent + 中间件:从头到尾就是同一个 Agent 对象。中间件每次调模型前都会
step = request.state.get("current_step")——第 1 轮读到triage,就穿上”前台”的提示词与工具;第 2 轮读到coffee,直接穿上”咖啡”的配置。没有第二个 Agent 被唤醒,也没有”前台再来一次”这个过程,所以省掉一次模型调用。- 多 Agent 子图:图入口有一条条件边
add_conditional_edges(START, route_initial, […]),route_initial读state["active_agent"]。第 2 轮它直接goto咖啡节点——前台节点是被路由”跳过”的,不是被咨询后放行的。- 前提是状态要活着:跨回合保留状态靠 checkpointer + 同一个
thread_id。如果没挂检查点,第 2 轮会从头开始(current_step回到triage),你就得再付一次交接调用,这张表里”省 1 次”的收益直接归零。- 它是”粘”的,不是”锁”的:咖啡 Agent 在第 2 轮若发现这活该转给别人,照样可以再调一次交接工具把
current_step改掉——只是默认不会每轮都重新判断”我该是谁”。机制细节与两种实现的完整代码见
05篇。
Skills:2 次 → 合计 5 次
sequenceDiagram participant U as 用户 participant A as Agent(同一个) participant SK as 技能库 load_skill participant T as 工具 buy_coffee
Note over U,T: 第 1 轮:买咖啡 —— 3 次模型调用 U->>A: 买咖啡 A->>A: ① 决定加载技能 A->>SK: load_skill("coffee") SK-->>A: 手册正文(进入上下文) A->>A: ② 按手册调用 buy_coffee A->>T: buy_coffee() T-->>A: 已下单 A->>A: ③ 回复用户 A-->>U: 咖啡买好了
Note over U,T: 第 2 轮:再买一杯 —— 2 次(省掉重新加载) U->>A: 再买一杯 Note over A: 手册还躺在上下文里,而且每轮都在为它付 token A->>A: ① 直接调用 buy_coffee A->>T: buy_coffee() T-->>A: 已下单 A->>A: ② 回复用户 A-->>U: 咖啡买好了这张时序图在说什么:① 第 1 轮多出的那一次是**“决定加载技能”,代价是手册正文被塞进上下文;② 第 2 轮这份手册还躺在对话历史里**,不用再加载,直接干活;③ 3 + 2 = 5 次。注意它的另一面:手册会一直占着上下文,每一轮都在为它付 token(这正是场景三里 Skills 调用最少却最贵的原因)。
Router:还是 3 次 → 合计 6 次
sequenceDiagram participant U as 用户 participant R as 路由 Router participant C as 咖啡 Agent participant T as 工具 buy_coffee
Note over U,T: 第 1 轮:买咖啡 —— 3 次模型调用 U->>R: 买咖啡 R->>R: ① 分类:判断该走哪个域 R->>C: 分发给被选中的 Agent(附上要办的事) C->>C: ② 调用 buy_coffee C->>T: buy_coffee() T-->>C: 已下单 C->>C: ③ 作答 C-->>R: 结论 R-->>U: 咖啡买好了(汇总后交给用户)
Note over U,T: 第 2 轮:再买一杯 —— 又是 3 次 U->>R: 再买一杯 Note over R: 路由器无状态:上一轮判过什么,它不记得 R->>R: ① 重新分类 R->>C: 分发给被选中的 Agent(附上要办的事) C->>C: ② 调用 buy_coffee C->>T: buy_coffee() T-->>C: 已下单 C->>C: ③ 作答 C-->>R: 结论 R-->>U: 咖啡买好了(汇总后交给用户)这张时序图在说什么:① 分类这一步每轮都要重做——路由器不记上一轮判过什么;② 后面两步(干活 + 作答)当然也要重跑;③ 3 + 3 = 6 次(单领域时”汇总”只是把专家的结论转交给用户,不再额外占一次模型调用;多领域并行时才需要真正的汇总,见场景三)。原文给的优化方向:把路由器包成有状态 Agent 的工具(见 07 篇的”有状态路由”),让分类结果能延续。
一句话对照:谁被重复付钱?
第 1 轮 第 2 轮Subagents 派活① + 干活②③ + 汇总④ = 4 派活① + 干活②③ + 汇总④ = 4 ← 整条链路重跑Handoffs 交接① + 干活② + 作答③ = 3 (交接已在状态里)干活①② = 2 ← 省掉「交接」Skills 加载① + 干活② + 作答③ = 3 (手册已在上下文里)干活①② = 2 ← 省掉「加载」Router 分诊① + 干活② + 作答③ = 3 分诊① + 干活② + 作答③ = 3 ← 整条链路重跑
规律:无状态模式(Subagents / Router)第 2 轮把整条链路重跑一遍; 有状态模式(Handoffs / Skills)第 2 轮省掉「进入状态」的那一步(交接 / 加载)。关键结论(原文)
Key insight:有状态模式(Handoffs、Skills)在重复请求上能省 40–50% 的调用。Subagents 则保持”每次请求成本恒定”——这种无状态设计换来强上下文隔离,代价是重复调用。
🧭 补充解读(非原文):这条结论的工程含义很实在——
- 如果你的业务重复请求占比高(比如客服来回追问同一件事),应该优先 Handoffs / Skills。
- 如果每次请求都几乎不相关(比如一次性的批处理任务),Subagents 的”恒定成本 + 强隔离”反而更省心。
场景三:多领域任务(一次问三个领域)
用户:“Compare Python, JavaScript, and Rust for web development”(比较三种语言做 Web 开发)
假设:每个语言 Agent / 技能各带 约 2000 token 的文档;所有模式都能并行调用工具。
| 模式 | 模型调用次数 | Token 总量 | 最合适? |
|---|---|---|---|
| Subagents | 5 | ~9K | ✅ |
| Handoffs | 7+ | ~14K+ | |
| Skills | 3 | ~15K | |
| Router | 5 | ~9K | ✅ |
Subagents:5 次调用,约 9K token
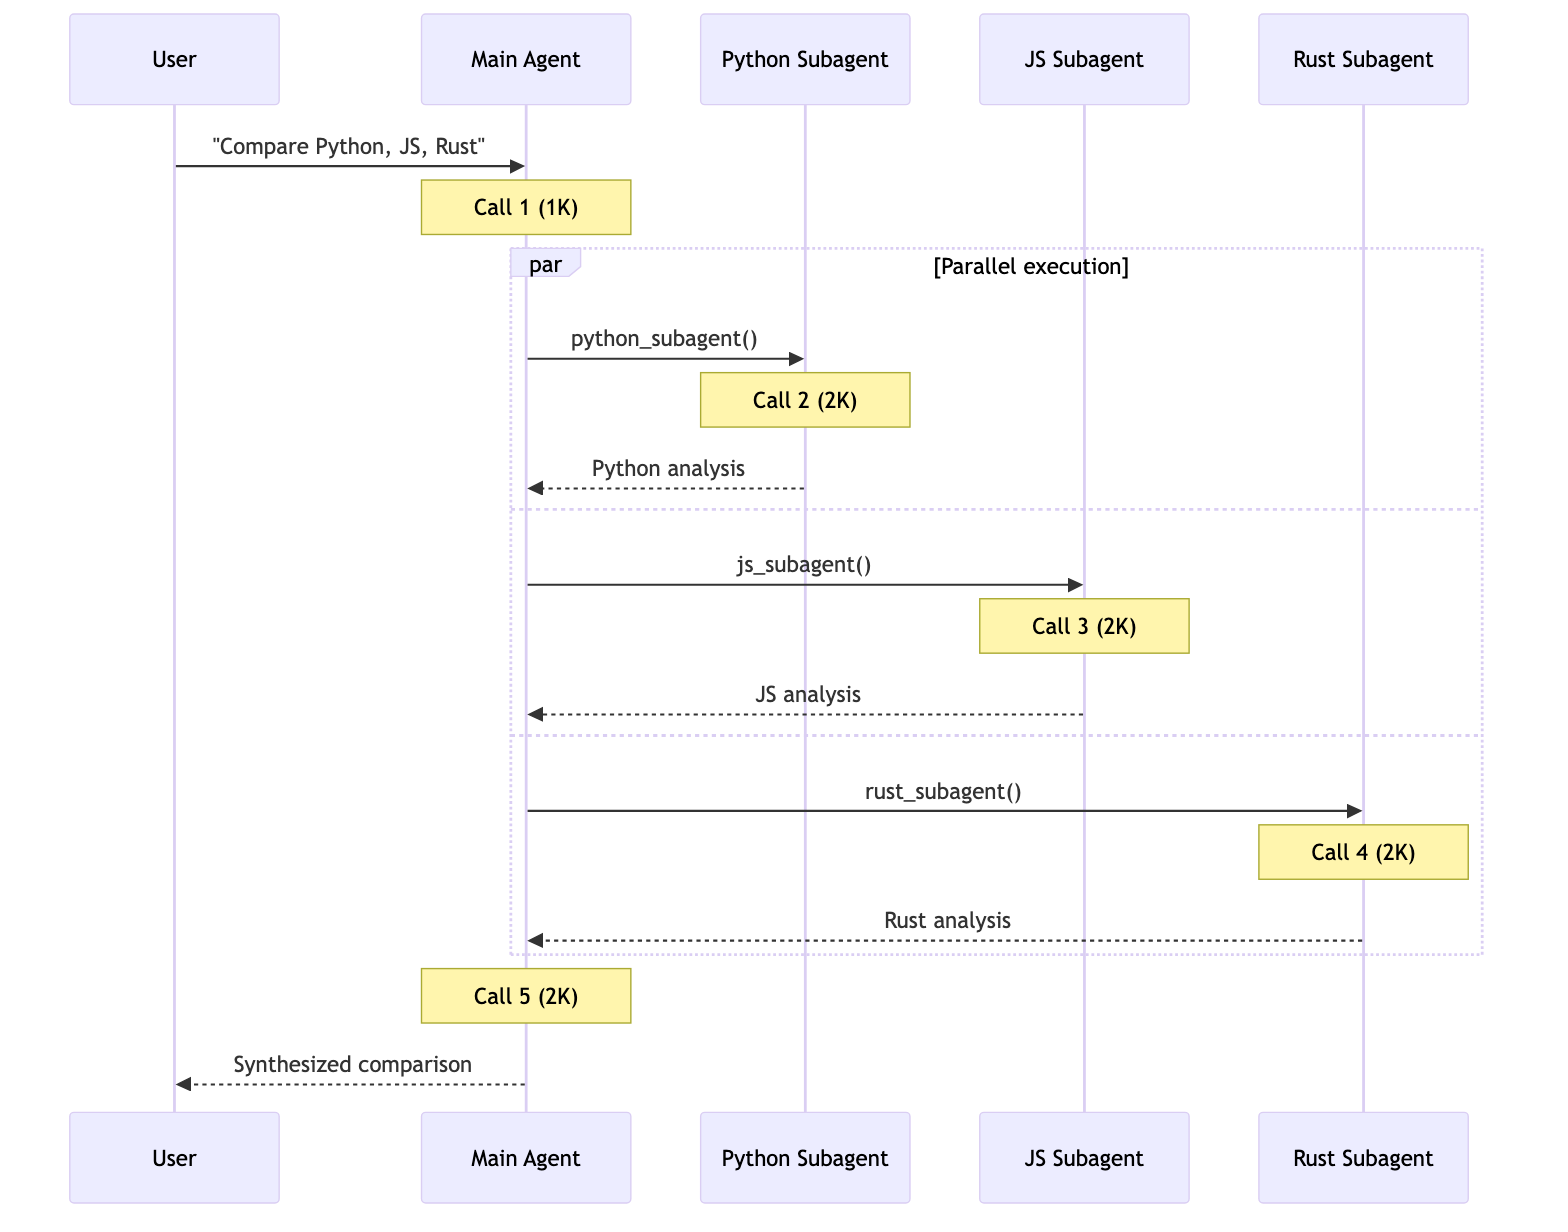
官方图注为「Subagents 多领域:5 次调用,含并行执行」。原文解读:每个子智能体在隔离的上下文里工作,只带自己相关的资料。总计 9K token。
🧭 补充解读(非原文,按原文结论推演):5 次 ≈ 主管决策(1)+ 三个语言子智能体各 1 次(3)+ 主管汇总(1)。
Handoffs:7+ 次调用,约 14K+ token
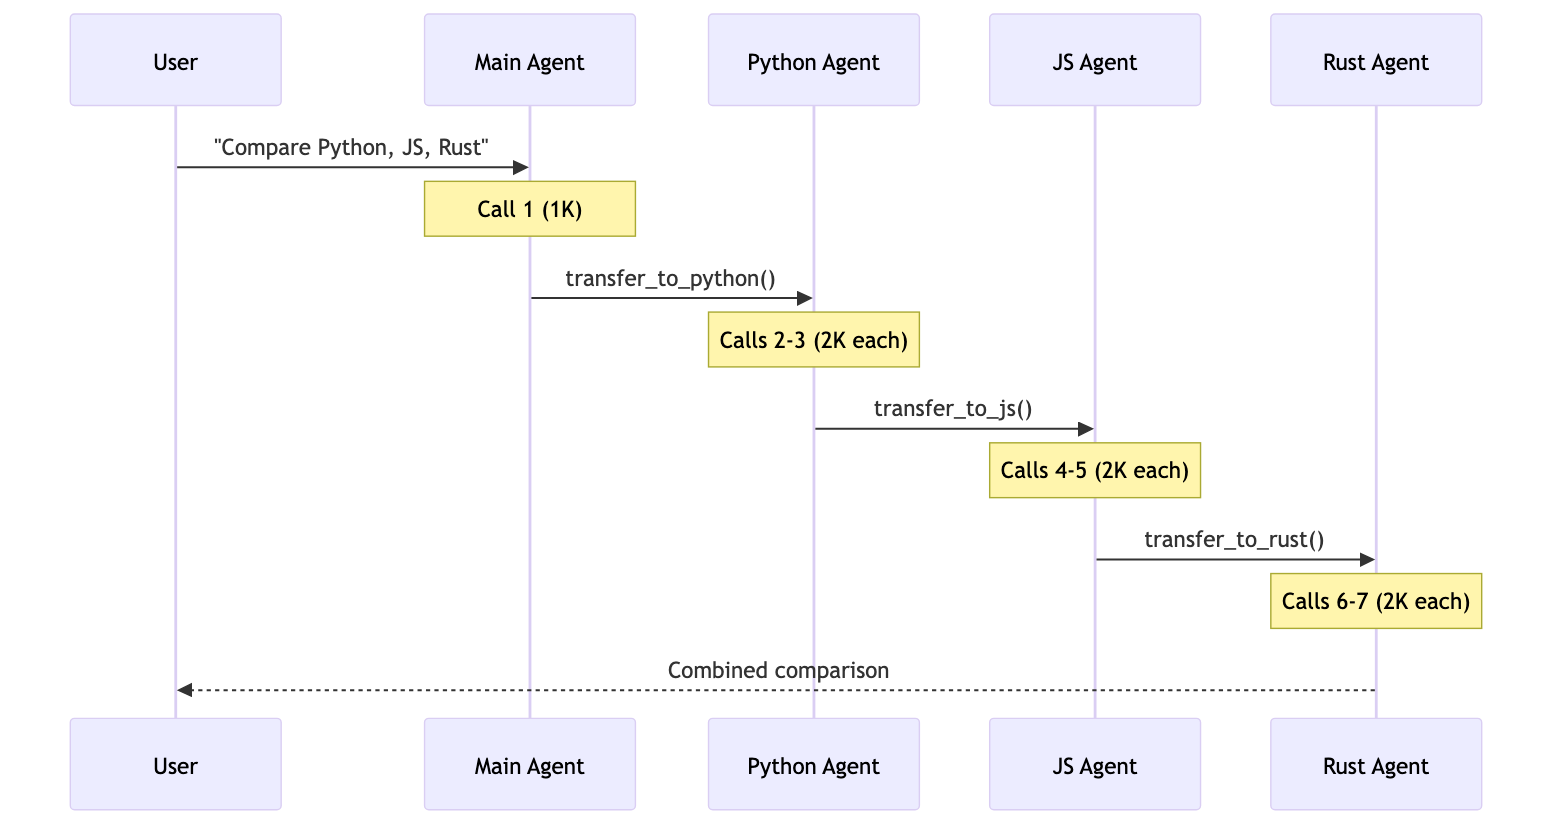
官方图注为「Handoffs 多领域:7 次以上串行调用」。原文解读:Handoffs 只能串行——没法同时研究三门语言;对话历史越来越长还额外加负担。总计 ~14K+ token。
Skills:3 次调用,约 15K token
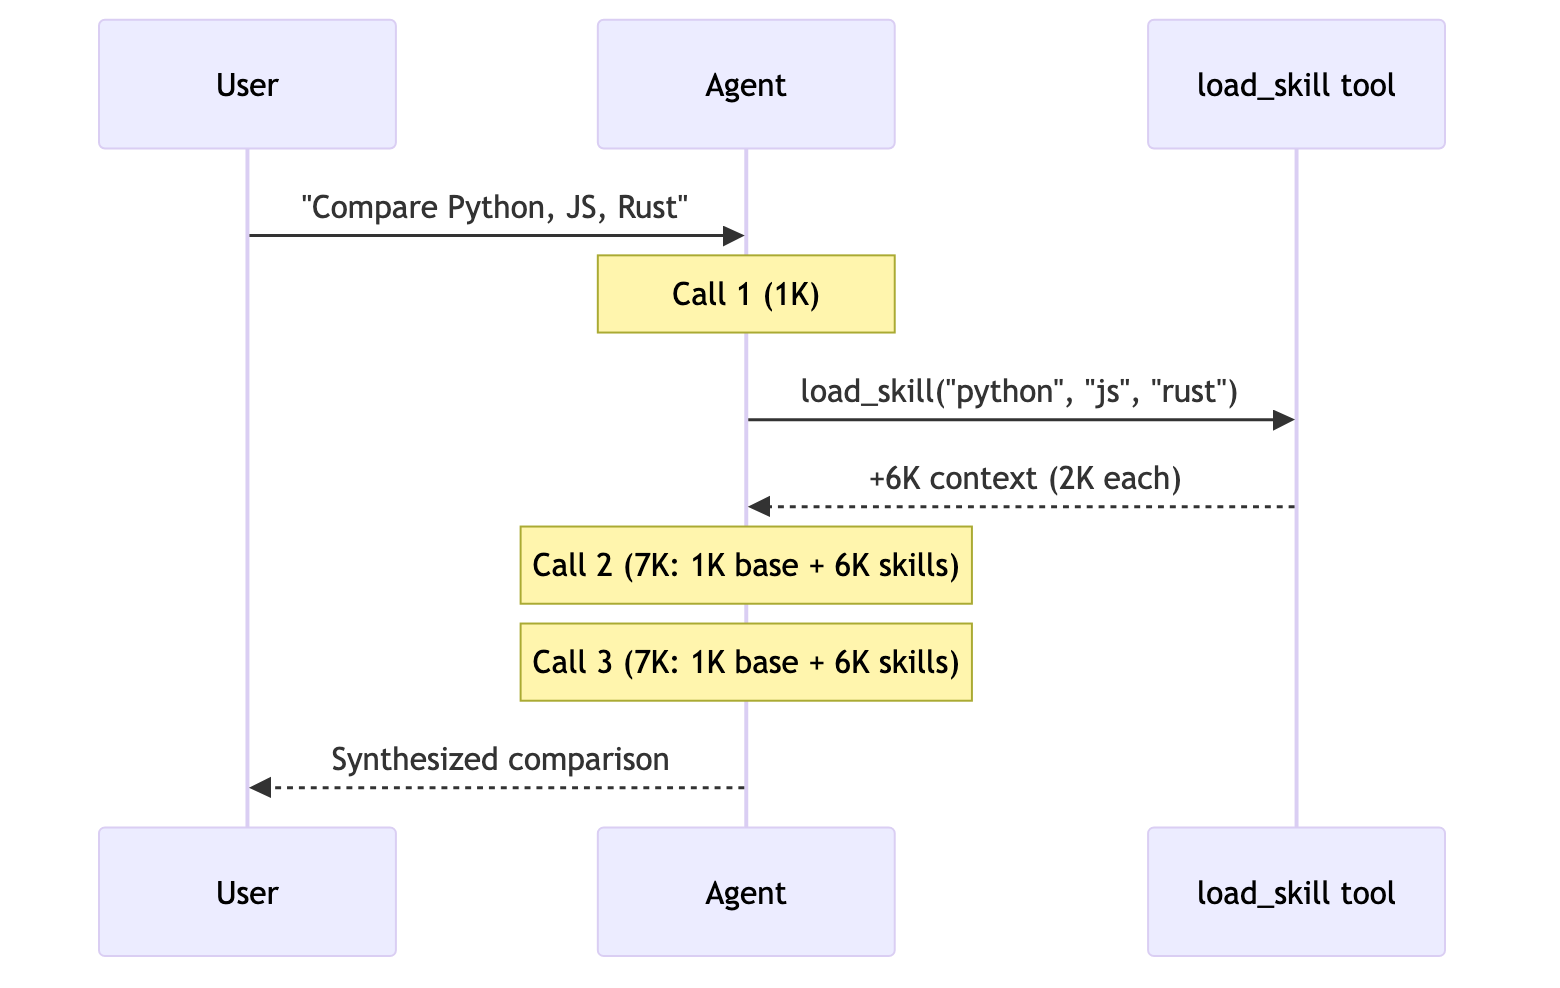
官方图注为「Skills 多领域:3 次调用,上下文累积」。原文解读:加载之后,后续每一次调用都要重新处理全部 6K token 的技能文档。因为上下文隔离,Subagents 整体处理的 token 比它少 67%。总计 15K token。
🧭 补充解读(非原文):这是本篇最有价值的一条反直觉结论—— 调用次数少 ≠ 便宜。Skills 只调 3 次,却因为”每轮都重读全部技能文档”而最贵。省调用和省 token 是两件事。
Router:5 次调用,约 9K token
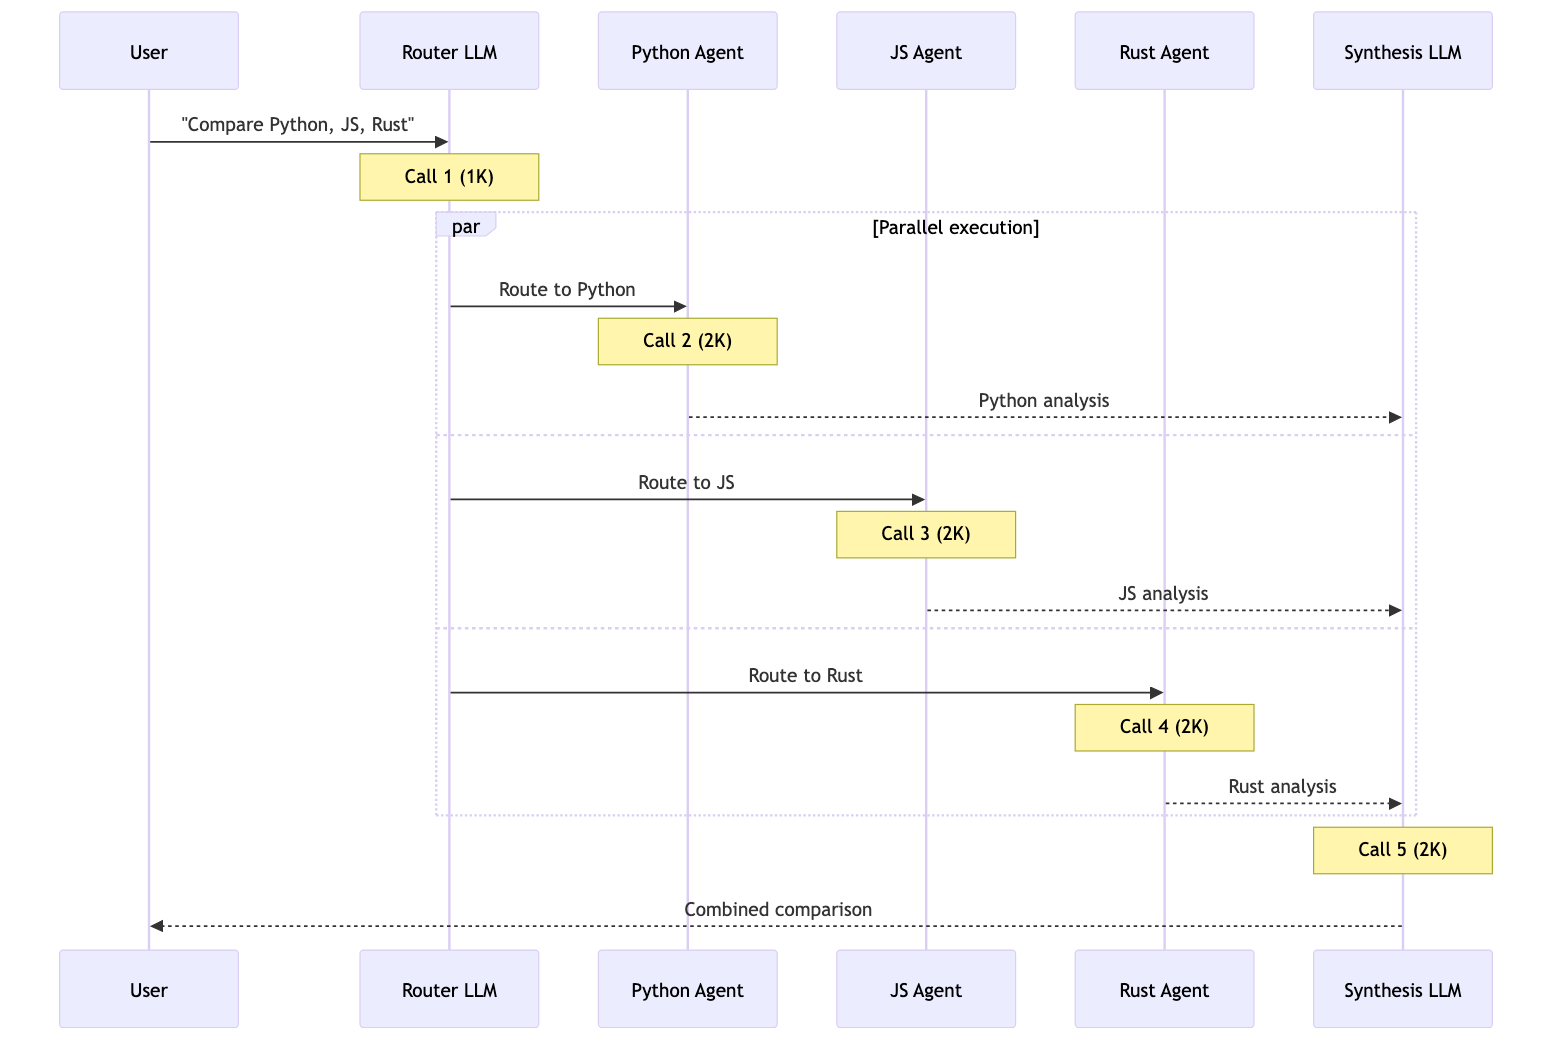
官方图注为「Router 多领域:5 次调用,含并行执行」。原文解读:Router 用一次 LLM 做路由,然后并行调起各专家。和 Subagents 类似,只是多了一个显式的路由步骤。总计 9K token。
关键结论(原文)
Key insight:多领域任务上,能并行的模式(Subagents、Router)最高效。Skills 调用少但 token 高(上下文累积)。Handoffs 在这里最吃亏——它必须串行,没法利用并行工具调用同时咨询多个领域。
三个场景放一起看
| 模式 | 一次性请求 | 重复请求 | 多领域 |
|---|---|---|---|
| Subagents | 4 calls | 8 calls (4+4) | 5 calls, 9K tokens |
| Handoffs | 3 calls | 5 calls (3+2) | 7+ calls, 14K+ tokens |
| Skills | 3 calls | 5 calls (3+2) | 3 calls, 15K tokens |
| Router | 3 calls | 6 calls (3+3) | 5 calls, 9K tokens |
按”优化目标”选(原文表)
| 优化目标 | Subagents | Handoffs | Skills | Router |
|---|---|---|---|---|
| 单次请求 | ✅ | ✅ | ✅ | |
| 重复请求 | ✅ | ✅ | ||
| 并行执行 | ✅ | ✅ | ||
| 大上下文领域 | ✅ | ✅ | ||
| 简单、聚焦的任务 | ✅ |
🧭 补充解读(非原文):如果只能记三句话——
- 只做一件事:Handoffs / Skills / Router,别用 Subagents(多一次汇总)。
- 同一会话反复做同一件事:Handoffs / Skills(有状态,第二轮就省了)。
- 一次涉及多个领域:Subagents / Router(能并行,token 还省);Handoffs 在这里是下策。
怎么把这些数字换算成你系统里的直觉
🧭 补充解读(非原文,方法论):
- 先测你自己的”一次调用”耗时:假设一次带工具的模型调用 1.5–3 秒,那么”3 次串行 ≈ 4.5–9 秒”。用户能不能忍,直接决定你能不能选串行模式(Handoffs)或必须并行(Subagents / Router)。
- 把调用次数换成钱:调用次数 × 平均 token × 单价。特别留意 Handoffs 的”历史越来越长”——它的成本是随轮次增长的,不是常数。
- 注意上下文上限:Skills 在多领域场景下 15K token 只是三门语言;换成十个领域,就是 60K+,很容易撞上限(也可能触发压缩,进一步加成本)。
- 看你的流量结构:重复请求多 → 有状态模式(Handoffs/Skills)收益最大;几乎都是独立请求 → Subagents 的恒定成本反而可预测、好做容量规划。
- ⚠️ 这个数不好直接取:一次调用耗时、平均 token 都能从 trace 里量出来,但”重复请求占比”不是一个现成字段,得先定义”什么叫重复”(同一会话里这一轮能否沿用上一轮的域/步骤)。定义、三种取数口径(业务主键 / 域标签 / 离线分类)、可直接套用的 SQL 模板与六个坑,单独写了一篇:
15附录:重复请求占比怎么统计。
- ⚠️ 这个数不好直接取:一次调用耗时、平均 token 都能从 trace 里量出来,但”重复请求占比”不是一个现成字段,得先定义”什么叫重复”(同一会话里这一轮能否沿用上一轮的域/步骤)。定义、三种取数口径(业务主键 / 域标签 / 离线分类)、可直接套用的 SQL 模板与六个坑,单独写了一篇:
- 别忘调试成本:Subagents 出问题时你要看”主管 → 子智能体 → 主管”三段轨迹;Handoffs 是”一个人一路走下来”,链路短但状态在变。可观测性成本也要算进选型(用 LangSmith 这类 trace 工具能省不少力)。
小结
- 两个指标别混:调用次数 ≈ 延迟与固定开销;token 总量 ≈ 账单与上下文压力。
- 一次性任务:Handoffs / Skills / Router 各 3 次调用,Subagents 4 次(多的一次是”汇总回主管”的集中管控成本)。
- 重复请求:有状态模式(Handoffs / Skills)第 2 轮只要 2 次调用,省 40–50%;Router 与 Subagents 每轮成本不变。
- 多领域任务:能并行的 Subagents / Router 最省(5 次调用、~9K token);Handoffs 串行最贵(7+ 次、14K+);Skills 调用最少(3 次)却最贵(15K)——少调用不等于少花钱。
- 这些是示意数字:用来建立”哪种模式在哪个场景吃亏”的直觉,真实决策请用自己的流量与实测数据。
一句话选型
- 看流量结构定大方向:重复请求多 → Handoffs / Skills;多领域并行多 → Subagents / Router;单发任务多 → Handoffs / Skills / Router(3 次调用)。
- 拿不准就先量三件事:一次调用的延迟、平均 token、重复请求占比——这三个数字基本就替你做完选型了。
上一篇:02 五种模式总览与选型 | 下一篇:04 Subagents 子智能体