TECH NOTE
5510 字 28 分钟 系列 12 / 2212 实战:用 Router 搭多源知识库(先分诊,再并行查,最后汇总)
ON THIS PAGE / 目录22 节
一句话讲透:这就像医院的分诊台。你跟护士说”我胸口疼,还头晕”,护士不会把你塞给一个”全能医生”,而是把你分到心内科、神经内科两个诊室同时排队,最后你自己把两份诊断意见合起来看。路由(Router)就是那个分诊台:先把问题拆开,再并行派给对口的专科 Agent,最后汇总成一份答案。
这个教程要解决什么
组织里的知识天然是分片的:代码在 GitHub,流程规范在 Notion,经验和踩坑在 Slack。用户问一句 “How do I authenticate API requests?”,答案可能同时散在这三个地方。
最直觉的做法是:给一个大 Agent 挂上所有工具,让它自己挑。三五个工具时能跑,规模一大就出事:
- 选错工具:工具从 7 个涨到 30 个,模型会”看着像就点”,检索质量断崖式下跌。
- 提示词被摊薄:一份 system prompt 要同时教它搜代码、读 Notion、聊 Slack,结果哪一块都不精。
- 上下文互相污染:A 源返回的噪音挤占了 B 源的推理空间,token 还烧得更快。
- 串行慢:一个 Agent 依次查三个源,端到端延迟是三次检索之和。
- 权限说不清:Slack 的私下讨论、Notion 的 HR 文档,未必该出现在每一个回答里。
原文的方案是把”一个什么都会的 Agent”换成”一个分诊台 + 几个专科 Agent”:
- 三个垂直领域(vertical):GitHub(搜代码 / issue / PR)、Notion(搜内部文档 / wiki)、Slack(搜讨论 / 线程)。
- 用户提问后,一次请求里完成三件事:分类(classify)→ 并行检索(parallel retrieval)→ 汇总(synthesis)。
也要先泼一盆冷水:别为了架构而架构。如果只有一个知识源、工具不到 5 个,单 Agent 挂工具就够了,Router 只会多给你一层模型调用和一张图要维护。
整体架构
graph LR A([用户问题 Query]) --> B[分诊 Router<br/>分类 Classify] B -->|并行分发 Send| C[GitHub Agent<br/>代码 / Issue / PR] B -->|并行分发 Send| D[Notion Agent<br/>内部文档 / Wiki] B -->|并行分发 Send| E[Slack Agent<br/>讨论 / 线程] C --> F[汇总 Synthesis<br/>归并 Reducer 收结果] D --> F E --> F F --> G([合并答案 Combined answer])这张图在说什么:
① 左边只有一次分诊:路由(Router)用一次模型调用把用户问题拆成一串”面向某个知识源的子问题”,而不是把原问题原样丢给三个 Agent。
② 中间是扇出(fan-out):被点名的 Agent 通过 LangGraph 的 Send 同时开跑;没被点名的(本例中的 Slack)根本不启动——省调用,也省延迟。
③ 右边是先归并、再汇总:归并函数(reducer)把并行结果拼成一个 list,随后一次”汇总”模型调用把它揉成不重复、有取舍的答案。
再看并行时序:
用户问题 ─▶ 分类(1 次模型调用) ├─▶ 知识源 A 检索 ─┐ ├─▶ 知识源 B 检索 ─┼─▶ 归并(reducer)─▶ 汇总回答 └─▶ 知识源 C 检索 ─┘ (1 次模型调用)注意这里的”1 次模型调用”只统计 Router 自己这一层。每个专科 Agent 内部还会自己调模型(先决定调哪个工具,再根据工具结果写答案),所以端到端通常是 1 + 被点名 Agent 各自的 1~2 次 + 1。
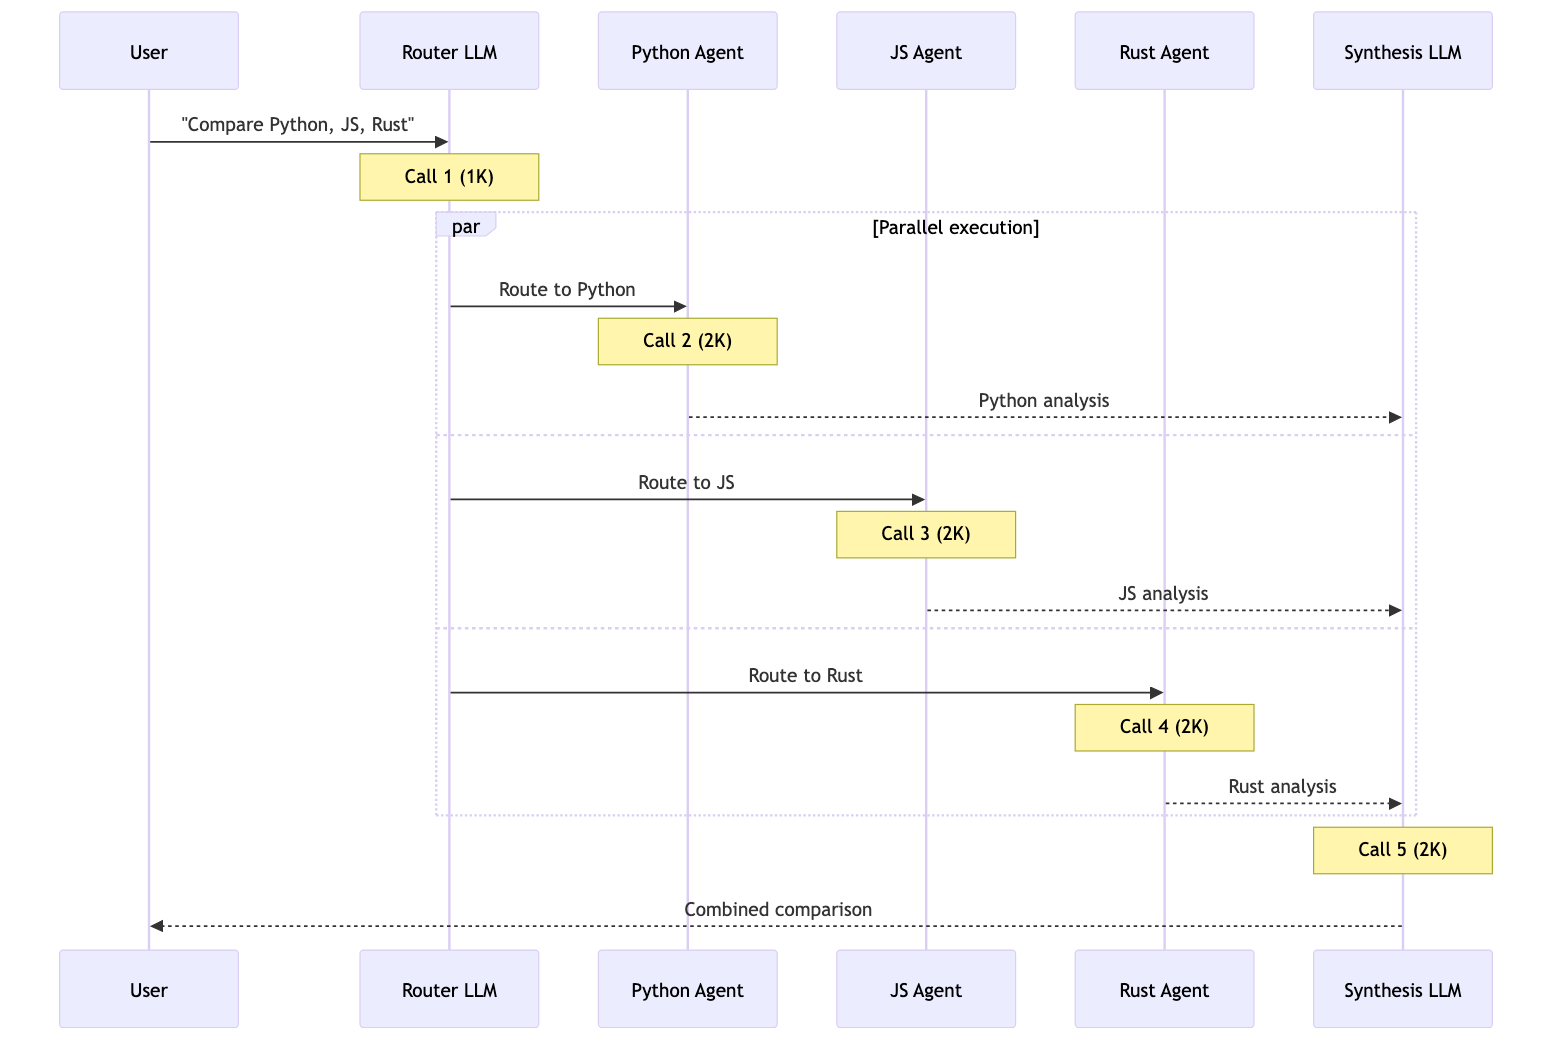
上图来自官方《Multi-agent》总览页的对比实验:跨领域任务下 Router 共 5 次模型调用、并行执行,token 约 9K。原图出处:https://docs.langchain.com/oss/python/langchain/multi-agent
分步拆解
§0 准备(原文 Setup 一节,压缩)
pip install langchain langgraphimport getpass, os
os.environ["LANGSMITH_TRACING"] = "true"os.environ["LANGSMITH_API_KEY"] = getpass.getpass()原文随后用 7 个标签页列了各家模型接法(OpenAI / Anthropic / Azure / Google Gemini / AWS Bedrock / HuggingFace / OpenRouter),这里不展开——换 Provider 只改 init_chat_model 那一行,后面代码完全不动。另外原文出现的 gpt-5.5、claude-sonnet-4-6 等模型名是它写作时的示例,照抄前请替换成你手头可用的模型。
§1 定义状态(state)
干什么:先把数据契约定下来——主图状态长什么样、子 Agent 收什么、回什么。为什么:并行节点之间不能靠互相传参通信,只能靠共享状态;契约定清楚了,Send 和归并函数才有地方落。
from typing import Annotated, Literal, TypedDictimport operator
class AgentInput(TypedDict): """每个子 Agent 的输入状态:只要一个问题。""" query: str
class AgentOutput(TypedDict): """每个子 Agent 的输出。""" source: str result: str
class Classification(TypedDict): """一条路由决策:调哪个 Agent、问它什么。""" source: Literal["github", "notion", "slack"] query: str
class RouterState(TypedDict): query: str classifications: list[Classification] results: Annotated[list[AgentOutput], operator.add] # 归并函数:并行结果累加 final_answer: str四个类型分工很清楚:AgentInput 是发给专科 Agent 的”精简挂号单”(只有 query,不带整张图的状态),AgentOutput 是回执,Classification 是一条路由决策,RouterState 是主图状态。注意 results 那一行的 Annotated[..., operator.add]——这是整篇最关键的一处声明,后面会专门讲。
§2 各知识源的工具
干什么:给每个垂直领域写工具。为什么:工具就是专科医生的”检查设备”,专科 Agent 的能力上限基本由工具决定。
原文一共 7 个工具:GitHub 三个(搜代码 / issue / PR)、Notion 两个(搜文档 / 取页面)、Slack 两个(搜消息 / 取线程)。生产环境里这些函数背后是真实的 API;教程里全是返回假数据的桩(stub)。下面只挑三个代表性写法(顺带一提:原文 search_prs 的返回值写成了 f"PR #156 added JWT authentication...",里面并没有占位符,f 前缀其实可以省——原文如此)。
from langchain.tools import tool
@tooldef search_code(query: str, repo: str = "main") -> str: """在 GitHub 仓库里搜代码。""" return f"Found code matching '{query}' in {repo}: authentication middleware in src/auth.py"
@tooldef search_issues(query: str) -> str: """搜 GitHub 的 issue 和 pull request。""" return f"Found 3 issues matching '{query}': #142 (API auth docs), #89 (OAuth flow), #203 (token refresh)"
# ...(略)另有 search_prs / search_notion / get_page / search_slack / get_thread,共 7 个工具函数的 docstring 不是装饰,它就是给模型看的工具说明——写清楚”什么时候用我”,比写清楚”我做了什么”更重要。
§3 专用 Agent
干什么:每个知识源建一个 Agent。为什么:把”领域知识”下沉到各自的工具集 + system prompt 里,谁也不用迁就谁。三个 Agent 结构完全同构,只换工具和提示词。
from langchain.agents import create_agentfrom langchain.chat_models import init_chat_model
model = init_chat_model("openai:gpt-5.5")
github_agent = create_agent( model, tools=[search_code, search_issues, search_prs], system_prompt=( "You are a GitHub expert. Answer questions about code, " "API references, and implementation details by searching " "repositories, issues, and pull requests." ),)# 中文大意:GitHub 专家,只从仓库 / issue / PR 里找代码与实现细节的答案
# notion_agent / slack_agent 写法完全一样,只是 tools 与 system_prompt 不同# ...(略)§4 路由工作流
干什么:把四个步骤写成节点函数——分类、扇出、查 Agent、汇总。为什么:这是整篇的核心,Send 和归并函数都在这节露面。
原文把工作流拆成四步:**分类(Classify)**决定叫谁、问什么;**路由(Route)**用 Send 扇出;查 Agent各自返回 AgentOutput;**汇总(Synthesize)**合成答案。
第一步,分类。用结构化输出(structured output)保证模型吐出的是合法结构,而不是一段需要正则去抠的 JSON:
from pydantic import BaseModel, Fieldfrom langgraph.graph import StateGraph, START, ENDfrom langgraph.types import Send
router_llm = init_chat_model("openai:gpt-5.4-mini")
class ClassificationResult(BaseModel): """把用户问题拆成若干「面向某个知识源的子问题」。""" classifications: list[Classification] = Field( description="List of agents to invoke with their targeted sub-questions" )
def classify_query(state: RouterState) -> dict: """分类:决定叫哪几个 Agent,并给每个 Agent 派一个定制子问题。""" structured_llm = router_llm.with_structured_output(ClassificationResult)
result = structured_llm.invoke([ {"role": "system", "content": SYSTEM_PROMPT}, {"role": "user", "content": state["query"]}, ])
return {"classifications": result.classifications}其中 SYSTEM_PROMPT 原文写得很长,核心就三句话(原文为英文,这里译成中文便于阅读):
- 列出三个源各自擅长什么:github 管代码 / API / 实现细节,notion 管内部文档 / 流程 / wiki,slack 管团队讨论与非正式知识。
- 只返回真正相关的源,并为每个源生成一个”为该知识域定制”的子问题。
- 给了个例子:
How do I authenticate API requests?只该拆给 github 和 notion,slack 不相关就直接省略。
第二步,扇出。这是全文最短也最值钱的函数:
def route_to_agents(state: RouterState) -> list[Send]: """扇出:把每条分类变成一次 Send,谁被点到谁就跑。""" return [ Send(c["source"], {"query": c["query"]}) for c in state["classifications"] ]Send 的第一个参数是目标节点名,第二个参数是只发给那个节点的状态。分类有几条,就发几路。
第三步,查 Agent。每个节点拿到的是精简后的 AgentInput,不是整张 RouterState:
def query_github(state: AgentInput) -> dict: """查 GitHub Agent。""" result = github_agent.invoke({ "messages": [{"role": "user", "content": state["query"]}] }) return {"results": [{"source": "github", "result": result["messages"][-1].content}]}
# ...(略)query_notion / query_slack 写法一模一样,只换 agent 变量与 source 名注意返回值:永远是包了一层的 list。因为并行节点各自往 results 里写,写的是”自己那一份”,拼起来交给归并函数去做。
第四步,汇总:
def synthesize_results(state: RouterState) -> dict: """汇总:等所有并行分支跑完,把结果揉成一个答案。""" if not state["results"]: return {"final_answer": "No results found from any knowledge source."}
formatted = [ f"**From {r['source'].title()}:**\n{r['result']}" for r in state["results"] ]
synthesis_response = router_llm.invoke([ {"role": "system", "content": ( f'把下面的检索结果汇总成对原始问题的回答:"{state["query"]}"\n' "- 合并多源信息,不要重复\n" "- 突出最相关、最可执行的内容\n" "- 标出来源之间的分歧\n" "- 保持简洁、有条理" )}, {"role": "user", "content": "\n\n".join(formatted)}, ])
return {"final_answer": synthesis_response.content}两个细节:空结果要兜底(一个源都没命中时别让模型硬编);提示词里带回原始问题(state["query"]),否则模型容易对着检索片段自说自话。
§5 编译图
干什么:把节点和边接起来并 compile()。为什么:静态边负责”谁接谁”,条件边 + Send 负责”这次到底跑哪几个”。
workflow = ( StateGraph(RouterState) .add_node("classify", classify_query) .add_node("github", query_github) .add_node("notion", query_notion) .add_node("slack", query_slack) .add_node("synthesize", synthesize_results) .add_edge(START, "classify") .add_conditional_edges("classify", route_to_agents, ["github", "notion", "slack"]) .add_edge("github", "synthesize") .add_edge("notion", "synthesize") .add_edge("slack", "synthesize") .add_edge("synthesize", END) .compile())三个 Agent 节点都连到 synthesize,LangGraph 会自动等所有被触发的分支跑完才进汇总节点——这就是免费的 join 屏障。
⚠️ 原文如此:
add_conditional_edges的第三个参数(["github", "notion", "slack"])是静态路径映射,通常是给”返回节点名字符串”的路由函数用的;这里路由函数返回的是Send对象,目标节点已经写在Send里了,所以这个列表对本次执行并不起决定作用。
§6 使用
干什么:喂一个问题进去,看看它拆成了几路、答案长什么样。为什么:分类结果是最值得观测的一环——它决定了后面所有成本和质量的走向。
result = workflow.invoke({ "query": "How do I authenticate API requests?"})
print("Original query:", result["query"])print("\nClassifications:")for c in result["classifications"]: print(f" {c['source']}: {c['query']}")print("\nFinal Answer:")print(result["final_answer"])原文给出的预期输出里,分类只有 github 和 notion 两路(Slack 被判定不相关),最终答案把 JWT、OAuth2、API Key 三种方式分条列出,并指向 PR #156、issue #203 等具体线索。这正好演示了 Router 的价值:不是三个源都查一遍,而是只查该查的。
§7 架构理解:四个阶段
原文把这套图拆成四个阶段来理解:
- 分类阶段(classification phase):
classify_query用结构化输出分析问题,路由智能就在这里。用 Pydantic 模型约束输出,比解析自由格式 JSON 可靠得多,也让路由逻辑显式可读;不相关的源直接不出现,而不是返回一个空查询。 - 并行执行(parallel execution with Send):
route_to_agents把分类映射成Send。例如分类是[{"source": "github", ...}, {"source": "notion", ...}],就变成[Send("github", {"query": "..."}), Send("notion", {"query": "..."})],两个 Agent 同时跑,各自只收到自己需要的那点状态。 - 结果收集(result collection with reducers):每个 Agent 返回
{"results": [{"source": "github", "result": "..."}]},归并函数(Python 里就是operator.add)把这些 list 拼起来,汇成state["results"]。 - 汇总阶段(synthesis phase):等所有并行分支结束(LangGraph 自动处理),对着原始问题把多源信息合并成一份不重复的答案。原文明确说明:这个教程里所有被选中的 Agent 必须全部完成才会进入汇总,没有”先到先汇总”的部分结果机制。
§8 完整示例
原文最后给了一份把上面所有片段拼在一起的完整脚本(imports + state + 7 个工具 + 3 个 Agent + 5 个节点 + 编译 + __main__ 演示),可以直接跑通演示流程。这里不整段复制,链接见下一节。
§9 进阶:有状态路由
到目前为止,这个 Router 是**无状态(stateless)**的:每次请求独立处理,两次调用之间没有记忆。多轮对话要记忆,原文给了两条路。
路线一:把 Router 包成一个工具(推荐)
思路:让 Router 继续无状态,记忆交给外面那个对话 Agent。对话 Agent 挂一个 search_knowledge_base 工具,需要查资料时才调 Router。
from langgraph.checkpoint.memory import InMemorySaver
@tooldef search_knowledge_base(query: str) -> str: """跨多个知识源(GitHub / Notion / Slack)检索。
需要查代码、文档或团队讨论时用它。 """ result = workflow.invoke({"query": query}) return result["final_answer"]
conversational_agent = create_agent( model, tools=[search_knowledge_base], system_prompt=( "You are a helpful assistant that answers questions about our organization. " "Use the search_knowledge_base tool to find information across our code, " "documentation, and team discussions." ), # 中文大意:组织知识助手,需要找信息就调 search_knowledge_base checkpointer=InMemorySaver(),)checkpointer + thread_id 负责记住对话,Router 只被当成一件”一次性的查询工具”:
config = {"configurable": {"thread_id": "user-123"}}result = conversational_agent.invoke( {"messages": [{"role": "user", "content": "How do I authenticate API requests?"}]}, config,)print(result["messages"][-1].content)💡 提示:原文推荐大多数场景用这条路线。职责干净——Router 负责多源查询,对话 Agent 负责上下文与记忆。
路线二:完整持久化
如果你需要 Router 自己记住状态(比如”上一轮查过什么”要影响这一轮的路由决策),就给 Router 这一层加持久化,把消息历史存在图里。
⚠️ 注意:有状态路由会显著增加复杂度。跨轮路由到不同 Agent 时,因为各自提示词和语气不同,用户会觉得对话”人格不一致”。原文建议:如果真需要多轮里切换不同 Agent,优先考虑交接(handoffs)模式或子 Agent(subagents)模式,它们对这种场景的语义更清楚。
关键机制专讲
① 分类为什么值得单独一次模型调用?规则或 embedding 行不行?
值得,但不必永远如此。这次调用买的是三样东西:该查哪几个源、每个源该问什么、不该查谁。第三条最容易被忽略——“不查 Slack”本身就是省钱省延迟的决策,规则很难写全。
能不能替代?分情况:
- 规则/关键词:如果你的三个源边界非常硬(比如按产品线切分,问题里出现”账单”就只查账单库),一条
if/elif比模型调用更稳、更快、更便宜。能用规则就别用模型。 - Embedding 相似度:适合”源很多、每个源有自己的描述语料”的场景——把用户问题分别和三个源的画像做相似度,超过阈值就入选。它比规则泛化好,但没法生成”定制子问题”,只能决定”查不查”。
- 模型分类:当源之间语义重叠(“认证”既可能在代码里也可能在文档里)、还需要把问题改写成面向该源的子问题时,模型才是划算的。注意用结构化输出 + 枚举约束,别让它自由发挥。
② Send 怎么做到分发到”数量不定”的节点?
普通条件边只能回答”下一步走哪一个分支”,分支集合必须在编译期就写死在图里。Send 换了个思路:路由函数返回的不是”下一站”,而是一份”投递单列表”。
return [Send(c["source"], {"query": c["query"]}) for c in state["classifications"]]LangGraph 拿到这个 list 后,为每个 Send 起一个独立的节点执行(同一个节点可以被投递多次),每个执行体拿到的是 Send 里那份独立的状态,而不是主状态。所以:3 条分类就并发 3 路,0 条分类就一路都不发(图直接走到 synthesize,由空结果兜底),运行时决定的”数量不定”就实现了。拓扑上你还是只画了 3 个 Agent 节点 + 1 条条件边。
③ 为什么必须有归并函数(reducer)?
因为并行分支会同时往同一个字段写。默认语义下,LangGraph 认为同一个 key 在一个 super-step 里被写多次是冲突,会直接报错——它没法猜你是想覆盖、想取最后一个,还是想拼接。
Annotated[list[AgentOutput], operator.add] 就是一次显式声明:这个字段的更新方式是”把新 list 接到旧 list 后面”。于是每个 Agent 只管返回自己那一份 {"results": [...]},归并交给声明去做,最后 synthesize 拿到的是完整的列表。
一句话记忆:并行写入的字段,必须能回答”两个值怎么合”。同理,如果你的并行节点都往 messages 写,就要用消息专用的归并方式,而不是默认覆盖。
④ 和子 Agent(subagents)模式差在哪?
两种模式都能”派活给多个 Agent”,区别在谁做决定、在哪做决定:
- 子 Agent 模式:主管 Agent 把子 Agent 当工具,模型在 ReAct 循环里一步一步决定”现在调谁、拿着上一轮结果再调谁”。控制权在 LLM 手里,灵活,但调用是一轮一轮串起来的,主管还要额外一轮把结果收回来再决定下一步。
- 路由模式:分诊是一个独立的前置阶段,一次性规划完”要查哪几路、每路问什么”,然后并行发射,最后统一汇总。控制权在开发者手里(你可以换提示词、加规则、改 schema),并行是图调度器保证的,不依赖模型自觉。
💡 提示:选择标准是——需要专门的预处理、自定义路由逻辑、明确的并行控制时用 Router;想让 LLM 动态决定调谁时用子 Agent 模式。前者的代价是每次请求都多一次路由模型调用(Router 无状态,第二轮对话还得再分诊一次)。
⑤ 有状态路由怎么选?
| 需求 | 选法 | 代价 |
|---|---|---|
| 单轮问答、多源检索 | 无状态 Router(本教程) | 无记忆,每轮都要重新分诊 |
| 多轮对话 + 需要查资料 | Router 包成工具 + 带 checkpointer 的对话 Agent(推荐) | 多一层对话 Agent 的调用开销 |
| 路由决策本身要用到历史检索结果 | Router 自身持久化 | 复杂度陡增,跨轮 Agent 切换体验不一致 |
判断口诀:记忆属于对话,不属于检索。绝大多数场景把记忆放在对话 Agent 那一层就够了;只有当”上一轮查到的内容”真的会改变”这一轮查哪几个源”时,才值得给 Router 上持久化。
完整代码在哪
- 官方原文(含完整可运行脚本,即原文 §8 Complete working example):https://docs.langchain.com/oss/python/langchain/multi-agent/router-knowledge-base
- 完整示例见原文 Complete working example 一节,它把 state 定义、7 个工具、3 个 Agent、5 个节点、编译与演示输出全部串在一起。
- 想横向对比四种多 Agent 模式(subagents / handoffs / skills / router)的调用次数与 token 开销,看官方总览页:https://docs.langchain.com/oss/python/langchain/multi-agent
- 安装只需
pip install langchain langgraph(或uv add langchain langgraph)。
本笔记只摘取骨架与关键片段,可能存在与原文的措辞差异;模型名、返回的假数据都以原文为准,未在本机实际运行验证。
小结
- Router 的本质是三段式:分类(decompose)→ 并行路由(route)→ 汇总(synthesize)。三段的职责不要混在一起写。
- 一次分诊换来三样东西:只查该查的源、给每个源定制子问题、让每个专科 Agent 的提示词和工具保持专精。
- 并行靠
Send,合并靠 reducer。Send让”跑几路”由运行时决定;Annotated[list[...], operator.add]让并行结果能安全地写回同一个字段。 - 结构化输出是路由可靠性的保险:用 Pydantic 模型约束分类结果,比解析自由格式 JSON 稳得多,也让路由逻辑显式可读。
- 无状态是好默认值:需要多轮记忆时,优先把 Router 包成一个工具交给带
checkpointer的对话 Agent,而不是一上来就给 Router 加持久化。
一句话选型
用 Router:你有多个相互独立、边界清晰的知识源(代码库 / 文档库 / 聊天记录 / 各业务线数据库),问题经常需要跨源取证,你希望并行以压低延迟,并且想让路由逻辑显式可控、可观测、可写测试。
别用 Router:只有一个知识源,或者工具总数不到 5 个——单 Agent 挂工具更简单;问题只需要问一个源、不需要汇总——用一个 Command 直接单路跳转就够;多轮里需要不同 Agent 轮流”接管”对话——用交接(handoffs)模式;想让 LLM 自己动态决定调谁、步步为营——用子 Agent(subagents)模式;能用 if/elif 或一张映射表确定性地分流——那就写 Python,别调模型。
💡 提示:这就是原文收尾给的选型口径——多个互相独立的知识源 + 想要低延迟的并行查询 + 想显式掌控路由逻辑,才上 Router;更简单的动态工具选择用子 Agent 模式,需要 Agent 与用户按顺序对话用交接(handoffs)模式。